Tìm hiểu DiffusionGemma là gì?
DiffusionGemma là một mô hình thực nghiệm mã nguồn mở được phát triển dựa trên nền tảng của dòng Gemma 4, kết hợp với các nghiên cứu tiên tiến từ Gemini Diffusion. Thay vì tuân thủ quy trình xử lý tuần tự (token-by-token) như các mô hình ngôn ngữ lớn (LLM) autoregressive thông thường, DiffusionGemma ứng dụng công nghệ text diffusion.
Cơ chế này cho phép mô hình tạo ra toàn bộ khối văn bản cùng một lúc thay vì đợi chờ từng từ. Với kiến trúc Mixture of Experts (MoE) 26B, mô hình chỉ kích hoạt khoảng 3.8B tham số trong mỗi lần suy luận, tạo nên sự cân bằng hoàn hảo giữa hiệu suất và tài nguyên phần cứng.
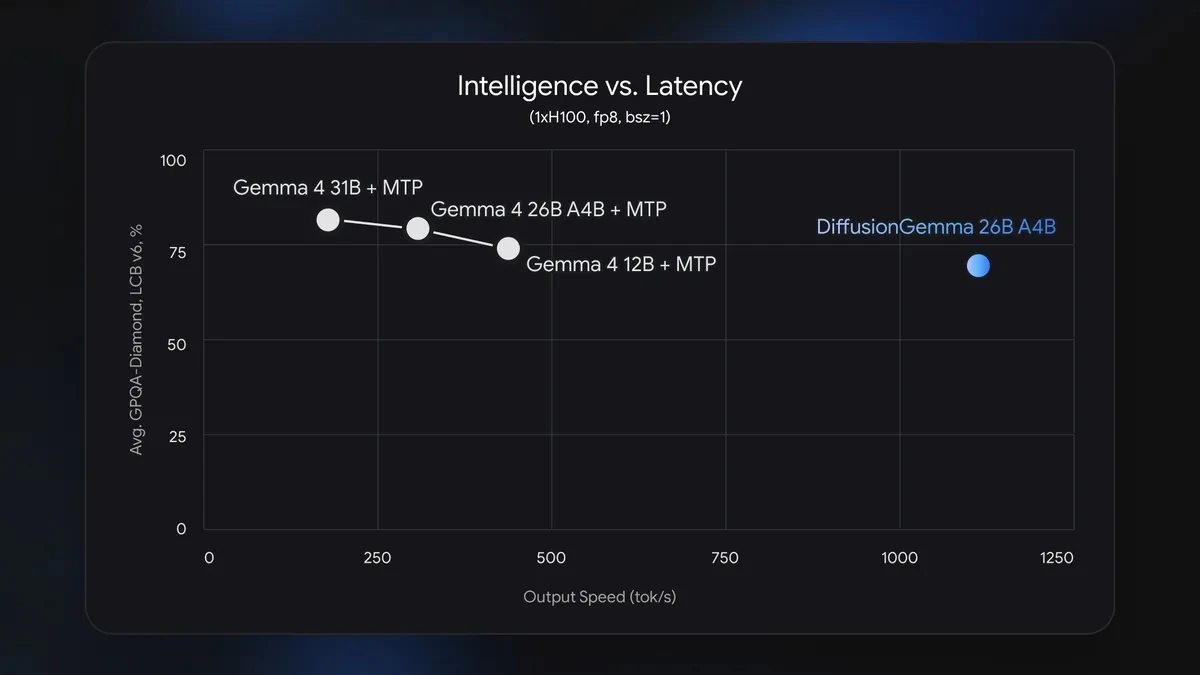
Tại sao DiffusionGemma thay đổi cuộc chơi về tốc độ?
Trong các kiến trúc LLM truyền thống, bộ xử lý đồ họa (GPU) thường bị lãng phí chu kỳ tính toán do phải chờ đợi mô hình tạo ra từng token kế tiếp. DiffusionGemma khắc phục triệt để điểm nghẽn này bằng cách:
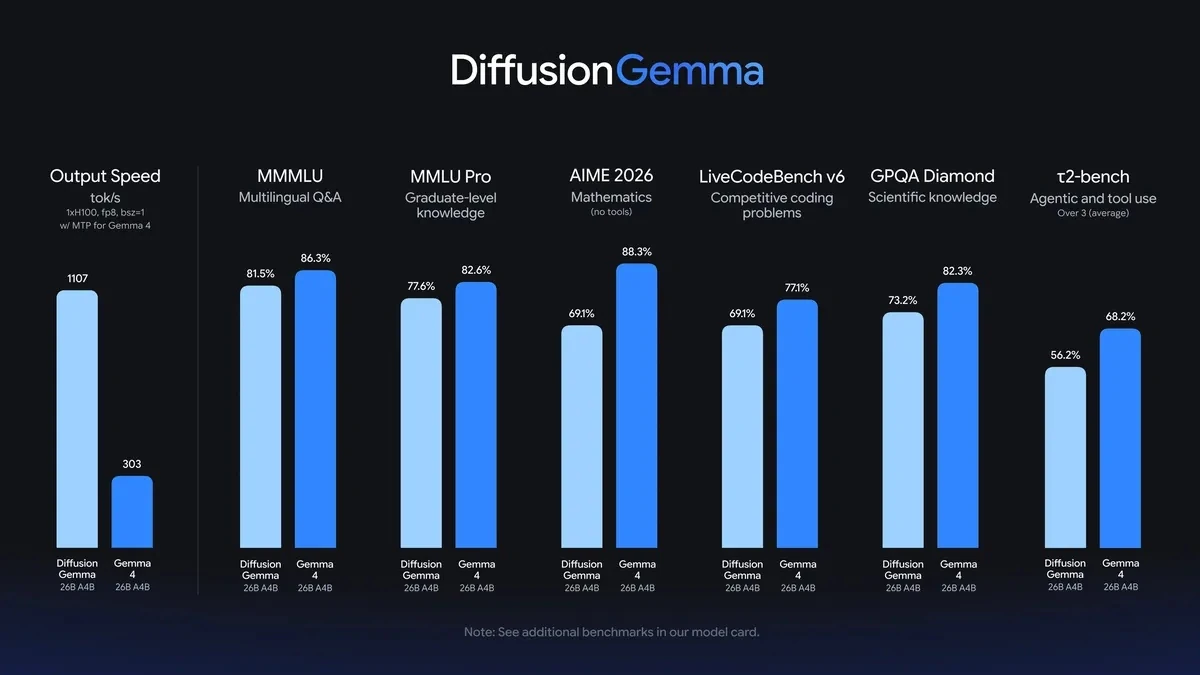
- Chuyển đổi trọng tâm từ băng thông sang tính toán: Bằng cách dự đoán cả đoạn văn bản thay vì từng từ đơn lẻ, mô hình tận dụng tối đa sức mạnh của GPU.
- Cơ chế song song: Khả năng tạo 256 token trong một lượt xử lý giúp giảm thiểu độ trễ, đặc biệt có lợi cho các ứng dụng tương tác thời gian thực.
- Tính năng tự sửa lỗi (Self-correction): Mô hình có thể đánh giá toàn bộ khối văn bản để điều chỉnh các sai sót ngay trong quá trình tạo, thay vì chỉ dựa vào xác suất của các từ trước đó.
So sánh hiệu năng: DiffusionGemma vs. LLM truyền thống
Để giúp các nhà phát triển hình dung rõ hơn về sự khác biệt, dưới đây là bảng so sánh khả năng vận hành của DiffusionGemma trên các cấu hình phần cứng phổ biến vào năm 2026:
| Tiêu chí | LLM Autoregressive (Truyền thống) | DiffusionGemma |
|---|---|---|
| Phương thức tạo | Tuần tự (Token-by-token) | Song song (Block-based) |
| Tốc độ trên H100 | Thấp (phụ thuộc độ dài chuỗi) | 1000+ tokens/giây |
| Tốc độ trên RTX 5090 | Trung bình | 700+ tokens/giây |
| Ứng dụng tối ưu | Sáng tạo nội dung dài, tổng quát | Chỉnh sửa văn bản, code, cấu trúc phi tuyến tính |
Ứng dụng thực tế của DiffusionGemma
DiffusionGemma không thay thế hoàn toàn các dòng mô hình cũ, mà được định hướng cho các nhu cầu cụ thể:
- Chỉnh sửa văn bản trực tuyến (In-line editing): Khả năng chú ý hai chiều (bi-directional attention) cho phép mô hình hiểu ngữ cảnh tốt hơn khi người dùng can thiệp vào giữa đoạn văn.
- Lập trình và điền code (Code infilling): Cực kỳ hiệu quả khi cần hoàn thiện các đoạn mã hoặc cấu trúc dữ liệu có tính logic cao.
- Tác vụ phi tuyến tính: Giải quyết các bài toán như Sudoku hoặc các chuỗi logic mà các mô hình dự đoán từ đơn lẻ thường gặp khó khăn.
- Tối ưu hóa Local Inference: Phù hợp cho các nhà phát triển muốn chạy ứng dụng AI ngay trên thiết bị cá nhân mà không bị nghẽn băng thông bộ nhớ.
Đánh giá từ chuyên gia: Khi nào nên sử dụng?
Dưới góc độ chuyên môn, DiffusionGemma là một công cụ mạnh mẽ nhưng cần được chọn lọc mục đích sử dụng:
- Sử dụng khi: Bạn cần tốc độ phản hồi cực nhanh, ứng dụng chạy cục bộ trên phần cứng cá nhân, hoặc các tác vụ yêu cầu tính toán song song như chỉnh sửa code, điền dữ liệu.
- Cần cân nhắc khi: Bạn đòi hỏi chất lượng đầu ra ở mức hoàn hảo nhất hoặc triển khai trên các hệ thống Cloud quy mô lớn (High-QPS), nơi các mô hình autoregressive truyền thống vẫn tối ưu hóa chi phí tốt hơn thông qua việc batching dữ liệu.
Lời khuyên: Hãy bắt đầu với việc tinh chỉnh (fine-tuning) DiffusionGemma cho những tác vụ chuyên biệt. Sự linh hoạt trong kiến trúc MoE của mô hình này sẽ mở ra nhiều khả năng mới cho các hệ thống AI tương tác trong năm 2026.