Bản chất trong quan điểm của Sam Altman về rủi ro AI
Trong các cuộc thảo luận về tương lai trí tuệ nhân tạo, Sam Altman thường đứng ở vị trí tương đối đặc biệt: ông vừa thúc đẩy quá trình phát triển và phổ cập AI, vừa nhiều lần nhấn mạnh rằng những hệ thống ngày càng mạnh cần đi kèm cơ chế quản trị và bảo đảm an toàn tương xứng. Vì vậy, quan điểm của Sam Altman về rủi ro AI không đơn thuần là lựa chọn giữa tăng tốc hoặc dừng phát triển công nghệ.
Cách tiếp cận phù hợp hơn để lý giải lập trường này là phân loại rủi ro theo mức độ nghiêm trọng và khả năng kiểm soát. Một số tác động tiêu cực có thể được giảm thiểu bằng thử nghiệm, giám sát, giới hạn quyền truy cập hoặc điều chỉnh sản phẩm. Ngược lại, những nguy cơ có khả năng gây thiệt hại trên quy mô lớn, khó đảo ngược hoặc vượt khỏi khả năng kiểm soát của con người đòi hỏi tiêu chuẩn an toàn cao hơn đáng kể.
Rủi ro thông thường và rủi ro có tính hệ thống
Cần phân biệt các vấn đề đã xuất hiện trong quá trình ứng dụng AI, chẳng hạn thông tin sai lệch, thiên kiến, lừa đảo hoặc lạm dụng công cụ, với những kịch bản rủi ro mang tính hệ thống. Nhóm thứ hai có thể liên quan đến việc AI hỗ trợ tấn công mạng ở quy mô lớn, bị khai thác trong các lĩnh vực nhạy cảm hoặc thực hiện chuỗi hành động tự động mà con người khó giám sát đầy đủ.
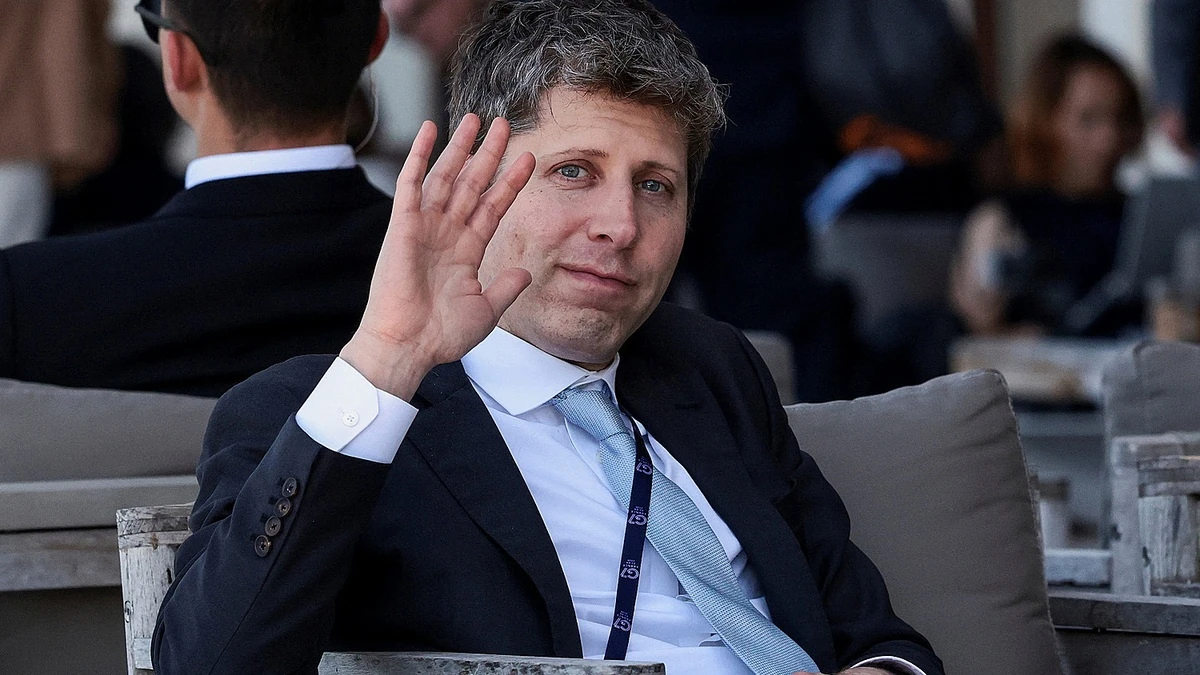
Sam Altman, CEO OpenAI, trong Hội nghị thượng đỉnh G7 diễn ra tại Evian-les-Bains, Pháp, ngày 17/6/2026. Ảnh:Reuters
Sự phân biệt này có ý nghĩa quan trọng đối với chính sách. Nếu mọi nguy cơ đều được xem như nhau, ngành công nghệ có thể rơi vào hai thái cực: hoặc kiểm soát quá mức khiến đổi mới bị cản trở, hoặc đánh giá thấp những kịch bản hiếm gặp nhưng hậu quả đặc biệt nghiêm trọng.
OpenAI và Anthropic khác nhau như thế nào về an toàn AI?
OpenAI và Anthropic đều đặt vấn đề an toàn vào chiến lược phát triển các mô hình AI tiên tiến, nhưng cách truyền đạt và thiết kế cơ chế quản trị có những điểm khác biệt. Không nên giản lược thành một bên ưu tiên tốc độ còn bên kia chỉ muốn làm chậm công nghệ; trên thực tế, cả hai đều phải giải quyết bài toán đánh đổi giữa năng lực mô hình, lợi ích kinh tế và mức độ rủi ro có thể chấp nhận.
Tiêu chí
OpenAI
Anthropic
Định hướng tổng thể
Phát triển AI có năng lực ngày càng cao song song với đánh giá và giảm thiểu rủi ro.
Nhấn mạnh mạnh vào nghiên cứu an toàn, khả năng kiểm soát và quản trị các mô hình tiên tiến.
Quản trị rủi ro
Sử dụng đánh giá năng lực, biện pháp bảo vệ và các khuôn khổ an toàn trước những mức năng lực nhạy cảm.
Xây dựng các ngưỡng năng lực và biện pháp bảo vệ tương ứng với mức độ rủi ro của hệ thống.
Cách nhìn về mô hình mạnh hơn
Tiềm năng mang lại lợi ích lớn nhưng cần tăng mức bảo vệ khi năng lực và khả năng tự chủ tăng.
Năng lực tăng có thể tạo ra rủi ro mới, vì vậy cơ chế an toàn cần được nâng cấp theo từng cấp độ.
Vai trò của quản lý nhà nước
Thừa nhận vai trò của các tiêu chuẩn và cơ chế quản trị đối với hệ thống AI tiên tiến.
Ủng hộ xây dựng các khuôn khổ quản trị dựa trên mức độ rủi ro và năng lực của mô hình.
Điểm giao nhau đáng chú ý là an toàn AI ngày càng được nhìn nhận như một quá trình liên tục thay vì bước kiểm tra cuối cùng trước khi phát hành sản phẩm. Khi mô hình có thêm năng lực, các bài kiểm thử, giới hạn truy cập, hệ thống giám sát và phương án ứng phó cũng cần thay đổi tương ứng.
Vì sao vấn đề an toàn AI ngày càng cấp thiết?
Trọng tâm của cuộc tranh luận hiện nay không chỉ nằm ở việc AI có thể tạo văn bản, hình ảnh hay mã nguồn tốt đến đâu. Điều quan trọng hơn là các hệ thống đang dần có khả năng sử dụng công cụ, xử lý nhiệm vụ nhiều bước và hoạt động với mức độ tự chủ cao hơn. Khi AI chuyển từ vai trò trả lời câu hỏi sang thực hiện hành động, phạm vi rủi ro cũng thay đổi.
Khả năng tự chủ làm thay đổi bài toán kiểm soát
Một mô hình chỉ tạo ra câu trả lời sai thường gây ra loại rủi ro khác với một hệ thống có quyền truy cập trình duyệt, mã nguồn, cơ sở dữ liệu hoặc các công cụ bên ngoài. Càng nhiều quyền hành động được trao cho AI, yêu cầu về phân quyền, xác thực, giám sát và khả năng dừng hệ thống càng trở nên quan trọng.
An ninh mạng có thể trở thành bài kiểm tra lớn
AI có khả năng hỗ trợ cả lực lượng phòng thủ lẫn các tác nhân tấn công mạng. Công nghệ có thể giúp phát hiện lỗ hổng, phân tích mã độc và phản ứng với sự cố nhanh hơn; ở chiều ngược lại, nó cũng có thể làm giảm chi phí của một số hoạt động dò quét, khai thác hoặc lừa đảo. Vì thế, đánh giá năng lực liên quan đến an ninh mạng là một phần quan trọng trong quản trị các mô hình tiên tiến.
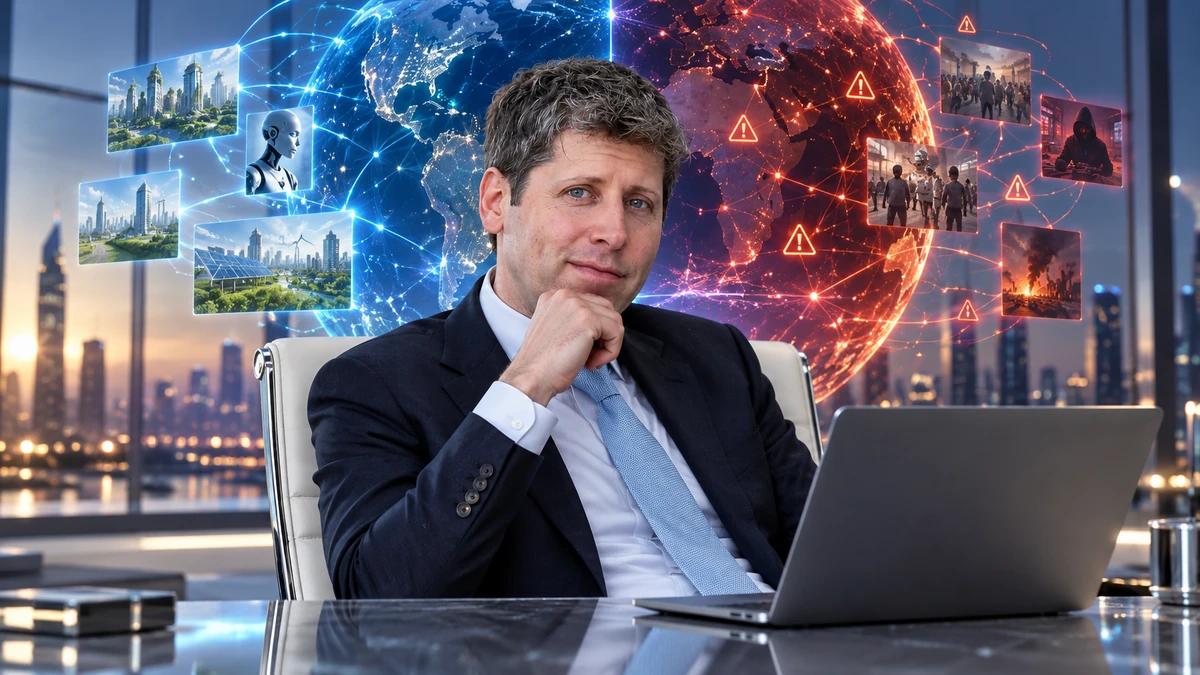
Sam Altman trong không gian công nghệ tương lai, phía sau là mạng lưới AI toàn cầu với hai nửa biểu trưng cho cơ hội và rủi ro
Rủi ro tăng khi AI kết nối với thế giới thực
Mức độ nguy hiểm của một hệ thống không chỉ phụ thuộc vào trí thông minh của mô hình mà còn phụ thuộc vào quyền truy cập được cấp cho nó. Một AI bị giới hạn trong môi trường thử nghiệm có hồ sơ rủi ro rất khác với tác nhân AI có thể thực thi mã, giao tiếp với dịch vụ bên ngoài hoặc đưa ra hành động tự động. Đây là lý do nguyên tắc cấp quyền tối thiểu và giám sát con người vẫn giữ vai trò thiết yếu.
Không nên đánh đồng cảnh báo rủi ro với dự báo thảm họa
Một điểm quan trọng khi phân tích quan điểm của Sam Altman về rủi ro AI là phải tách biệt cảnh báo về một kịch bản với khẳng định rằng kịch bản đó chắc chắn xảy ra. Việc chuẩn bị cho những sự kiện xác suất thấp nhưng hậu quả rất lớn là nguyên tắc quen thuộc trong an toàn hàng không, an ninh mạng, tài chính và nhiều hệ thống trọng yếu khác.
Quản trị AI hiệu quả không đòi hỏi phải biết chắc một kịch bản nguy hiểm sẽ xảy ra. Điều cần thiết là xác định hậu quả, khả năng xảy ra và những lớp bảo vệ hợp lý trước khi hệ thống đạt tới mức năng lực khó kiểm soát.
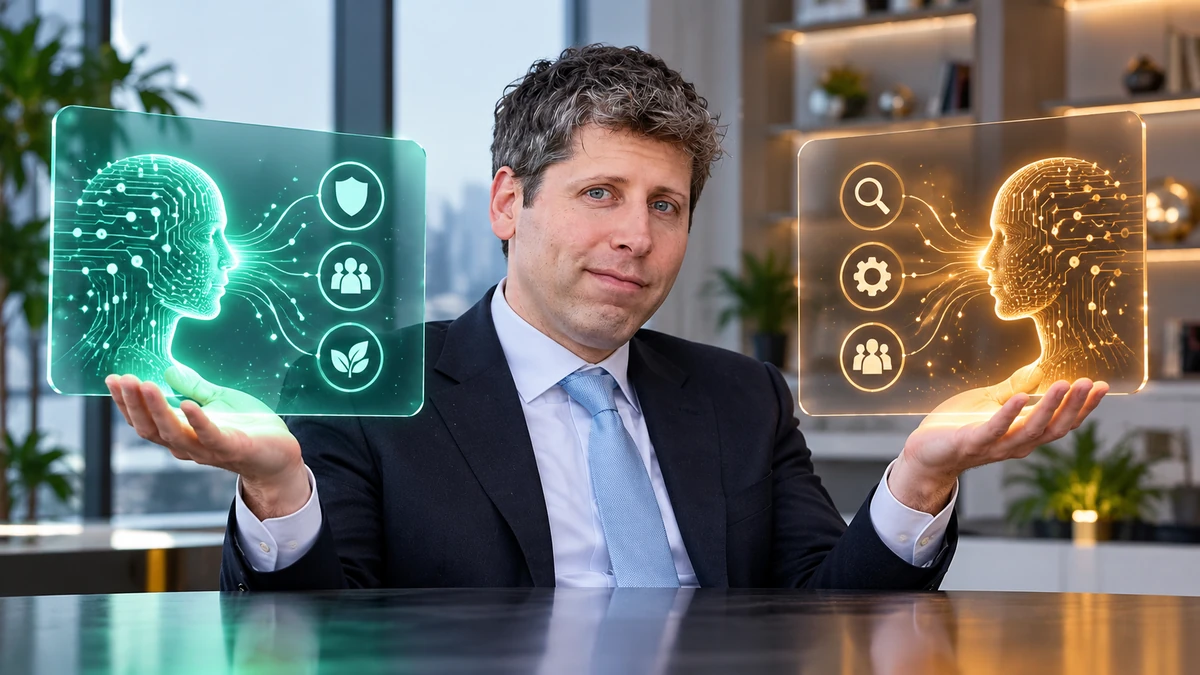
Cận cảnh sơ đồ trực quan đối chiếu hai hướng quản trị an toàn AI của OpenAI và Anthropic
Cách tiếp cận dựa trên rủi ro cũng giúp cuộc tranh luận tránh rơi vào hai cực đối lập: xem AI như mối đe dọa tất yếu hoặc cho rằng mọi cảnh báo đều mang tính cường điệu. Cả lợi ích lẫn nguy cơ cần được đánh giá bằng bằng chứng, thử nghiệm và dữ liệu thực tế.
Bốn lớp bảo vệ cần thiết cho các hệ thống AI tiên tiến
Đánh giá năng lực trước khi triển khai
Các mô hình mạnh cần được kiểm thử có hệ thống đối với những năng lực nhạy cảm như an ninh mạng, khả năng thao túng, tự động hóa nhiệm vụ phức tạp hoặc sử dụng công cụ. Đánh giá độc lập và red teaming có thể giúp phát hiện những hành vi mà quá trình thử nghiệm nội bộ chưa bao phủ.
Giới hạn quyền truy cập theo mức độ rủi ro
Không phải mọi hệ thống AI đều cần quyền truy cập như nhau. Phân quyền theo nguyên tắc tối thiểu, cô lập môi trường thực thi và yêu cầu xác nhận của con người trước các hành động nhạy cảm có thể hạn chế đáng kể hậu quả khi mô hình mắc lỗi hoặc bị lợi dụng.
Giám sát và cơ chế dừng an toàn
Thay vì chỉ dựa vào một nút ngắt duy nhất, hệ thống an toàn nên có nhiều lớp: theo dõi hành vi bất thường, giới hạn tốc độ, thu hồi quyền truy cập, cô lập tác nhân và cho phép con người can thiệp. Cơ chế dừng chỉ thực sự hữu ích khi được thiết kế, thử nghiệm và vận hành như một phần của kiến trúc tổng thể.
Thiết lập chuẩn quản trị vượt ra ngoài từng doanh nghiệp
AI tiên tiến là vấn đề xuyên biên giới, vì vậy các tiêu chuẩn đánh giá và báo cáo sự cố không thể chỉ phụ thuộc vào cam kết tự nguyện của từng công ty. Cơ quan quản lý, giới nghiên cứu, doanh nghiệp và các tổ chức tiêu chuẩn cần phối hợp để xây dựng những yêu cầu phù hợp với mức độ năng lực và rủi ro thực tế của hệ thống.
Giá trị đáng chú ý nhất trong cuộc tranh luận về rủi ro AI không nằm ở việc lựa chọn giữa lạc quan và bi quan. Vấn đề thực tế hơn là xã hội có thể khai thác lợi ích của những mô hình ngày càng mạnh trong khi vẫn duy trì quyền kiểm soát, khả năng giám sát và trách nhiệm giải trình hay không.
Quan điểm của Sam Altman về rủi ro AI cho thấy một nghịch lý trung tâm của ngành công nghệ: chính những năng lực khiến AI trở nên hữu ích cũng có thể làm tăng mức độ thiệt hại nếu hệ thống bị sử dụng sai hoặc vận hành ngoài dự kiến. Do đó, tốc độ phát triển cần song hành với tốc độ cải thiện các tiêu chuẩn an toàn.
Ở góc độ dài hạn, một hệ sinh thái AI bền vững không nên dựa hoàn toàn vào lời hứa của lãnh đạo doanh nghiệp, cũng không thể chỉ dựa vào quy định cứng nhắc. Cách tiếp cận khả thi hơn là kết hợp nghiên cứu kỹ thuật, kiểm thử độc lập, quản trị theo mức độ rủi ro, minh bạch phù hợp và hợp tác quốc tế. Khi các lớp bảo vệ phát triển cùng năng lực của mô hình, xã hội mới có cơ hội tận dụng giá trị của AI mà không xem nhẹ những hậu quả tiềm tàng.