Cloudflare AI Gateway là gì và đóng vai trò gì trong hệ sinh thái AI?
Cloudflare AI Gateway có thể được xem như một lớp trung gian giữa ứng dụng và các dịch vụ AI mà ứng dụng cần gọi. Thay vì để từng thành phần kết nối trực tiếp tới nhiều nhà cung cấp, nhà phát triển có thể đưa lưu lượng qua một điểm quản trị tập trung để quan sát, kiểm soát và tối ưu quá trình sử dụng mô hình.
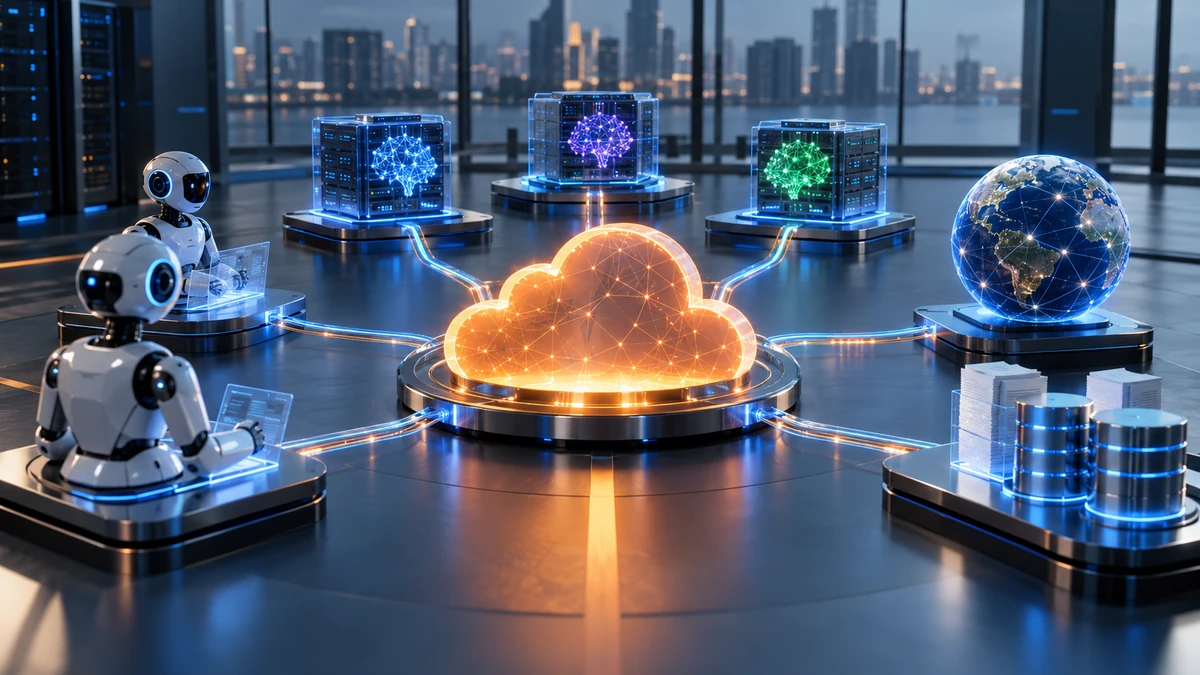
Cách tiếp cận này đặc biệt hữu ích với AI Agent. Một Agent hiện đại thường không chỉ gửi prompt tới mô hình ngôn ngữ lớn mà còn phải tương tác với công cụ tìm kiếm, API, cơ sở dữ liệu và nhiều nguồn ngữ cảnh khác. Khi số lượng kết nối tăng lên, lớp gateway giúp kiến trúc dễ quản trị hơn và giảm việc gắn chặt logic ứng dụng với từng dịch vụ riêng lẻ.
Vì sao Web Search API quan trọng với AI Agent?
Mô hình ngôn ngữ lớn có giới hạn về phạm vi và thời điểm của dữ liệu mà nó đã được huấn luyện. Với những câu hỏi phụ thuộc vào thông tin mới, việc chỉ dựa vào kiến thức nội tại của mô hình có thể dẫn đến câu trả lời lỗi thời hoặc thiếu căn cứ. Web Search API bổ sung một kênh truy xuất dữ liệu bên ngoài trước khi Agent tổng hợp phản hồi.
Bổ sung dữ liệu cập nhật từ web
Khả năng tìm kiếm cho phép Agent truy xuất các tài liệu mới xuất hiện trên internet, phù hợp với những tác vụ như nghiên cứu thị trường, tổng hợp thông tin sản phẩm, theo dõi xu hướng hoặc xử lý câu hỏi mà dữ liệu thay đổi thường xuyên.
Hỗ trợ giảm rủi ro hallucination
Web Search không tự động loại bỏ hiện tượng AI tạo thông tin sai. Tuy nhiên, khi mô hình được cung cấp tài liệu liên quan và quy trình buộc Agent dựa trên nguồn truy xuất trước khi trả lời, khả năng đưa ra các khẳng định thiếu căn cứ có thể được hạn chế đáng kể.
Mở rộng mô hình Retrieval-Augmented Generation
RAG thường được triển khai với kho dữ liệu nội bộ hoặc cơ sở dữ liệu vector. Web Search bổ sung một lớp retrieval khác: internet. Nhà phát triển có thể kết hợp dữ liệu doanh nghiệp với nguồn công khai trên web để tạo ngữ cảnh phong phú hơn cho mô hình.
Các nhà cung cấp Web Search API trong hệ sinh thái tích hợp
Các dịch vụ tìm kiếm dành cho AI có cách tiếp cận khác nhau về lập chỉ mục, truy xuất và định dạng kết quả. Vì vậy, nhà phát triển nên đánh giá chất lượng dữ liệu thực tế theo từng use case thay vì chỉ dựa vào số lượng kết quả tìm kiếm.
| Nhà cung cấp | Định hướng sử dụng | Trường hợp nên đánh giá |
|---|---|---|
| Ceramic | Cung cấp khả năng truy xuất dữ liệu phục vụ ứng dụng AI | Các workflow cần bổ sung nguồn dữ liệu bên ngoài cho Agent |
| Exa | Tìm kiếm và truy xuất nội dung web được thiết kế cho ứng dụng AI | Research Agent, RAG và các tác vụ cần lấy nội dung web làm ngữ cảnh |
| Linkup | Truy xuất thông tin web để cung cấp dữ liệu cho mô hình AI | Ứng dụng cần tìm kiếm, tổng hợp và đối chiếu thông tin từ internet |
Không có lựa chọn tối ưu cho mọi bài toán. Các tiêu chí đáng xem xét gồm độ liên quan của kết quả, độ mới của dữ liệu, khả năng trả về nội dung nguồn, độ trễ, giới hạn truy vấn và tổng chi phí trên mỗi tác vụ Agent.
Luồng hoạt động của AI Agent khi kết hợp Web Search
Một kiến trúc hiệu quả không nên kích hoạt tìm kiếm web cho mọi prompt. Agent cần xác định khi nào kiến thức nội tại của mô hình là đủ và khi nào câu hỏi thực sự cần dữ liệu bên ngoài.
Bước 1: Phân loại yêu cầu của người dùng
Ứng dụng xác định truy vấn có phụ thuộc vào thông tin mới, dữ liệu bên ngoài hoặc bằng chứng từ nguồn cụ thể hay không. Những câu hỏi mang tính giải thích kiến thức ổn định có thể không cần tìm kiếm.
Bước 2: Gửi truy vấn tới công cụ tìm kiếm phù hợp
Nếu cần retrieval, Agent xây dựng truy vấn tìm kiếm dựa trên ý định của người dùng. Với các tác vụ phức tạp, một câu hỏi có thể được tách thành nhiều truy vấn nhỏ để cải thiện phạm vi và độ chính xác của tài liệu thu thập.
Bước 3: Lọc và chuẩn hóa ngữ cảnh
Kết quả tìm kiếm không nên được chuyển nguyên trạng vào mô hình. Hệ thống cần loại bỏ nội dung trùng lặp, ưu tiên nguồn đáng tin cậy, giới hạn lượng văn bản và chuẩn hóa dữ liệu trước khi đưa vào context window.
Bước 4: Sinh câu trả lời dựa trên nguồn truy xuất
LLM nhận câu hỏi cùng phần ngữ cảnh đã chọn lọc để tổng hợp câu trả lời. Với các ứng dụng yêu cầu độ tin cậy cao, giao diện nên hiển thị nguồn hoặc liên kết tham chiếu để người dùng có thể kiểm chứng thông tin.
Cách triển khai Web Search với Cloudflare AI Gateway
Ở cấp độ kiến trúc, nhà phát triển nên tách ba lớp gồm logic Agent, lớp truy xuất dữ liệu và lớp gọi mô hình. AI Gateway có thể đóng vai trò điểm kiểm soát cho lưu lượng AI, trong khi Cloudflare Workers đảm nhiệm orchestration và xử lý logic nghiệp vụ ở lớp ứng dụng.
Điều phối bằng Cloudflare Workers
Workers có thể tiếp nhận yêu cầu từ người dùng, xác định nhu cầu tìm kiếm, gọi dịch vụ retrieval, xử lý kết quả và sau đó gửi context tới mô hình. Cách tổ chức này giúp logic Agent không phụ thuộc quá sâu vào giao diện phía client.
Chỉ tìm kiếm khi thực sự cần thiết
Mỗi lần gọi công cụ đều làm tăng độ trễ và có thể phát sinh chi phí. Một routing layer đơn giản có thể phân biệt câu hỏi cần dữ liệu mới với câu hỏi thông thường, qua đó tránh gọi Web Search API không cần thiết.
Cache kết quả có thời hạn phù hợp
Những truy vấn lặp lại có thể được cache để giảm số lần gọi API. Tuy nhiên, thời gian lưu cần phụ thuộc vào bản chất dữ liệu: thông tin ít biến động có thể cache lâu hơn, trong khi giá, sự kiện hoặc tin tức cần thời gian sống ngắn để tránh trả về dữ liệu cũ.
Web Search không đồng nghĩa với câu trả lời luôn chính xác
Một sai lầm phổ biến khi xây dựng AI Agent là cho rằng kết nối internet sẽ giải quyết hoàn toàn vấn đề độ tin cậy. Công cụ tìm kiếm cũng có thể trả về nội dung lỗi thời, SEO spam, thông tin thiếu ngữ cảnh hoặc các nguồn mâu thuẫn nhau.
Chất lượng của AI Agent phụ thuộc không chỉ vào việc nó có thể tìm kiếm hay không, mà còn vào khả năng lựa chọn nguồn, đánh giá bằng chứng và sử dụng đúng dữ liệu trong quá trình suy luận.
Vì vậy, các hệ thống quan trọng nên thiết lập chính sách ưu tiên nguồn, kiểm tra thời gian xuất bản, đối chiếu nhiều tài liệu khi cần và giữ lại thông tin nguồn để phục vụ kiểm chứng. Nội dung lấy từ web cũng cần được xem là dữ liệu không đáng tin cậy về mặt bảo mật, đặc biệt trong các Agent có quyền gọi công cụ hoặc thực hiện hành động.
Những lưu ý về bảo mật và kiểm soát chi phí
- Giới hạn truy vấn: Thiết lập rate limiting và ngân sách để ngăn vòng lặp Agent tạo ra quá nhiều lượt tìm kiếm hoặc inference.
- Không tin tuyệt đối nội dung web: Dữ liệu truy xuất có thể chứa chỉ dẫn độc hại hoặc prompt injection; hệ thống không nên coi nội dung từ website là lệnh dành cho Agent.
- Bảo vệ dữ liệu nhạy cảm: Tránh đưa thông tin nội bộ, khóa API hoặc dữ liệu cá nhân không cần thiết vào truy vấn tìm kiếm bên ngoài.
- Theo dõi độ trễ và chi phí: Đánh giá toàn bộ chuỗi search, retrieval và inference thay vì chỉ đo thời gian phản hồi của mô hình.
- Ghi nhận nguồn: Với các tác vụ nghiên cứu và tổng hợp, nên lưu URL, tiêu đề hoặc metadata cần thiết để có thể truy vết nguồn của câu trả lời.
Đánh giá: Web Search đang trở thành lớp hạ tầng quan trọng của AI Agent
Điểm đáng chú ý của Cloudflare AI Gateway tích hợp Web Search API không nằm ở việc bổ sung thêm một nút tìm kiếm cho chatbot. Giá trị lớn hơn là khả năng đưa retrieval vào cùng kiến trúc vận hành Agent, nơi nhà phát triển có thể kiểm soát luồng dữ liệu, mô hình, độ trễ và chi phí theo một quy trình thống nhất.
Đối với doanh nghiệp, mô hình phù hợp là coi Web Search như một nguồn dữ liệu động bên cạnh dữ liệu nội bộ. Agent chỉ kích hoạt nguồn này khi nhiệm vụ cần thông tin bên ngoài, sau đó đánh giá và tổng hợp bằng chứng trước khi đưa ra câu trả lời.
Cách tiếp cận đó giúp AI Agent tiến gần hơn từ một hệ thống chỉ biết sinh văn bản sang một ứng dụng có khả năng tìm kiếm, thu thập ngữ cảnh và phản hồi dựa trên thông tin cập nhật. Tuy nhiên, hiệu quả cuối cùng vẫn phụ thuộc vào thiết kế retrieval, chất lượng nguồn, cơ chế bảo mật và khả năng quan sát toàn bộ workflow của nhà phát triển.