EmbeddingGemma là gì?
EmbeddingGemma là mô hình nhúng văn bản (text embedding model) do Google DeepMind phát triển, được tối ưu để tạo ra các biểu diễn vector nhỏ gọn nhưng giàu thông tin ngữ nghĩa. Thay vì sinh câu trả lời như một mô hình ngôn ngữ lớn, EmbeddingGemma chuyển văn bản đầu vào thành các dãy số để máy tính có thể đo lường mức độ tương đồng về ý nghĩa.
Điểm quan trọng cần làm rõ là EmbeddingGemma hiện được Google giới thiệu là mô hình nhúng văn bản, không phải mô hình nhúng đa phương thức cho hình ảnh, video và âm thanh. Mô hình có khoảng 308 triệu tham số, được xây dựng từ Gemma 3 với phương pháp khởi tạo liên quan đến T5Gemma và hướng tới các thiết bị phổ thông như điện thoại, laptop hay máy tính cá nhân.
Nhờ kích thước tương đối nhỏ, EmbeddingGemma phù hợp với tìm kiếm ngữ nghĩa, Retrieval-Augmented Generation (RAG), phân loại, phân cụm dữ liệu và truy xuất mã nguồn. Đây cũng là một ví dụ tiêu biểu cho xu hướng đưa nhiều tác vụ AI từ máy chủ đám mây xuống thiết bị của người dùng.
EmbeddingGemma hoạt động như thế nào?
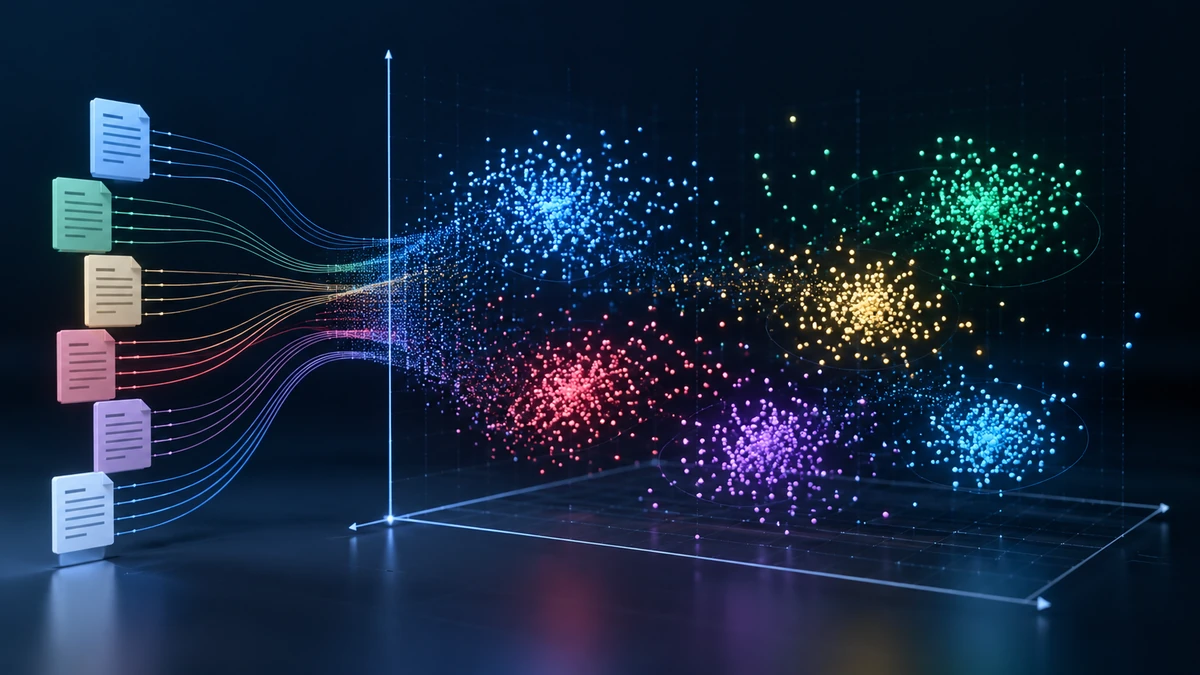
Về bản chất, mô hình nhận một đoạn văn bản và ánh xạ nội dung đó vào một không gian vector. Hai câu có ý nghĩa gần nhau thường được biểu diễn bởi những vector nằm gần nhau, ngay cả khi chúng không sử dụng chính xác cùng một bộ từ khóa.
Kiến trúc của EmbeddingGemma sử dụng transformer theo hướng encoder để đọc ngữ cảnh hai chiều. Sau quá trình xử lý token, các biểu diễn được tổng hợp bằng mean pooling, đi qua các lớp chiếu tuyến tính và chuẩn hóa để tạo embedding cuối cùng. Vector mặc định có 768 chiều.
Cơ chế này đặc biệt hữu ích cho tìm kiếm ngữ nghĩa. Chẳng hạn, một truy vấn như “cách giảm dung lượng ảnh trên điện thoại” vẫn có thể tìm thấy tài liệu nói về “nén hình ảnh trên smartphone” dù hai chuỗi không trùng khớp hoàn toàn về từ khóa.
Những ưu điểm nổi bật của EmbeddingGemma
Thiết kế nhỏ gọn cho AI on-device
EmbeddingGemma có khoảng 308 triệu tham số và được Google định hướng rõ ràng cho các tác vụ AI chạy trên thiết bị. Với lượng tử hóa phù hợp, mô hình có thể vận hành với mức sử dụng RAM dưới 200 MB trong những cấu hình được Google công bố. Điều này tạo điều kiện triển khai semantic search hoặc RAG trên phần cứng có tài nguyên hạn chế.
Xử lý embedding cục bộ còn mang lại một lợi ích quan trọng về quyền riêng tư: nội dung nhạy cảm có thể được vector hóa ngay trên thiết bị thay vì bắt buộc gửi lên một dịch vụ từ xa. Tuy nhiên, mức độ riêng tư cuối cùng vẫn phụ thuộc vào kiến trúc của toàn bộ ứng dụng, không chỉ riêng mô hình embedding.
Hỗ trợ hơn 100 ngôn ngữ
Mô hình được huấn luyện với dữ liệu thuộc hơn 100 ngôn ngữ, phù hợp cho các hệ thống tìm kiếm và truy xuất thông tin đa ngôn ngữ. Đây là lợi thế đáng chú ý đối với ứng dụng cần xử lý kho tài liệu có nhiều ngôn ngữ thay vì duy trì một mô hình riêng cho từng thị trường.
Matryoshka Representation Learning giúp giảm kích thước vector
EmbeddingGemma hỗ trợ Matryoshka Representation Learning (MRL). Vector đầy đủ có 768 chiều nhưng nhà phát triển có thể rút gọn xuống 512, 256 hoặc 128 chiều rồi chuẩn hóa lại, qua đó cân bằng giữa chất lượng truy xuất, tốc độ tính toán và dung lượng lưu trữ.
Ví dụ, nếu mỗi thành phần vector được lưu bằng cùng một kiểu dữ liệu, embedding 128 chiều chỉ cần khoảng một phần sáu số phần tử so với vector 768 chiều. Với hàng triệu tài liệu, chênh lệch này có thể ảnh hưởng đáng kể đến dung lượng vector database và chi phí truy vấn.
Ngữ cảnh đầu vào tối đa 2K token
EmbeddingGemma hỗ trợ đầu vào tối đa khoảng 2.048 token. Đây là mức đủ hữu ích cho nhiều đoạn tài liệu, câu hỏi và đơn vị dữ liệu trong hệ thống RAG, nhưng không nên nhầm với cửa sổ ngữ cảnh 8K token của một số mô hình khác.
Tối ưu cho nhiều nhiệm vụ truy xuất
Ngoài document retrieval, EmbeddingGemma có thể được sử dụng cho question answering, fact verification, classification, clustering, semantic similarity và code retrieval. Google cung cấp các dạng prompt theo nhiệm vụ để giúp embedding phản ánh đúng mục đích sử dụng, thay vì áp dụng một cách biểu diễn giống nhau cho mọi bài toán.
Thông số đáng chú ý của EmbeddingGemma
| Đặc tính | EmbeddingGemma | Ý nghĩa thực tế |
|---|---|---|
| Quy mô | Khoảng 308 triệu tham số | Nhỏ gọn, phù hợp thiết bị có tài nguyên giới hạn |
| Loại dữ liệu | Văn bản | Tập trung vào text embedding, không phải embedding đa phương thức |
| Mô hình nền tảng | Gemma 3 | Kế thừa công nghệ từ hệ sinh thái Gemma |
| Ngôn ngữ | Hơn 100 ngôn ngữ | Phù hợp tìm kiếm và truy xuất đa ngôn ngữ |
| Kích thước vector | 768, 512, 256 hoặc 128 chiều | Linh hoạt cân bằng chất lượng, tốc độ và lưu trữ |
| Ngữ cảnh đầu vào | Tối đa khoảng 2K token | Phù hợp các đoạn tài liệu trong semantic search và RAG |
| Tối ưu bộ nhớ | Dưới 200 MB RAM khi lượng tử hóa trong cấu hình Google công bố | Thuận lợi cho triển khai on-device |
| Benchmark nổi bật | MTEB | Đánh giá khả năng embedding văn bản trên nhiều nhóm tác vụ |
Matryoshka Representation Learning có gì đặc biệt?
MRL có thể hình dung như những lớp thông tin được lồng vào nhau. Thay vì phải huấn luyện một mô hình riêng cho embedding 128 chiều và một mô hình khác cho 768 chiều, quá trình huấn luyện giúp phần đầu của vector vẫn duy trì khả năng biểu diễn hữu ích khi vector bị cắt ngắn.
Điều này cho phép nhà phát triển lựa chọn cấu hình theo bài toán. Hệ thống cần ưu tiên chất lượng có thể giữ vector 768 chiều; ứng dụng di động hoặc kho dữ liệu rất lớn có thể thử 256 hay 128 chiều để giảm bộ nhớ và chi phí tìm kiếm. Việc lựa chọn kích thước phù hợp nên được kiểm chứng bằng dữ liệu thực tế của ứng dụng thay vì mặc định rằng vector nhỏ hơn luôn đủ tốt.
Ứng dụng EmbeddingGemma trong hệ thống RAG
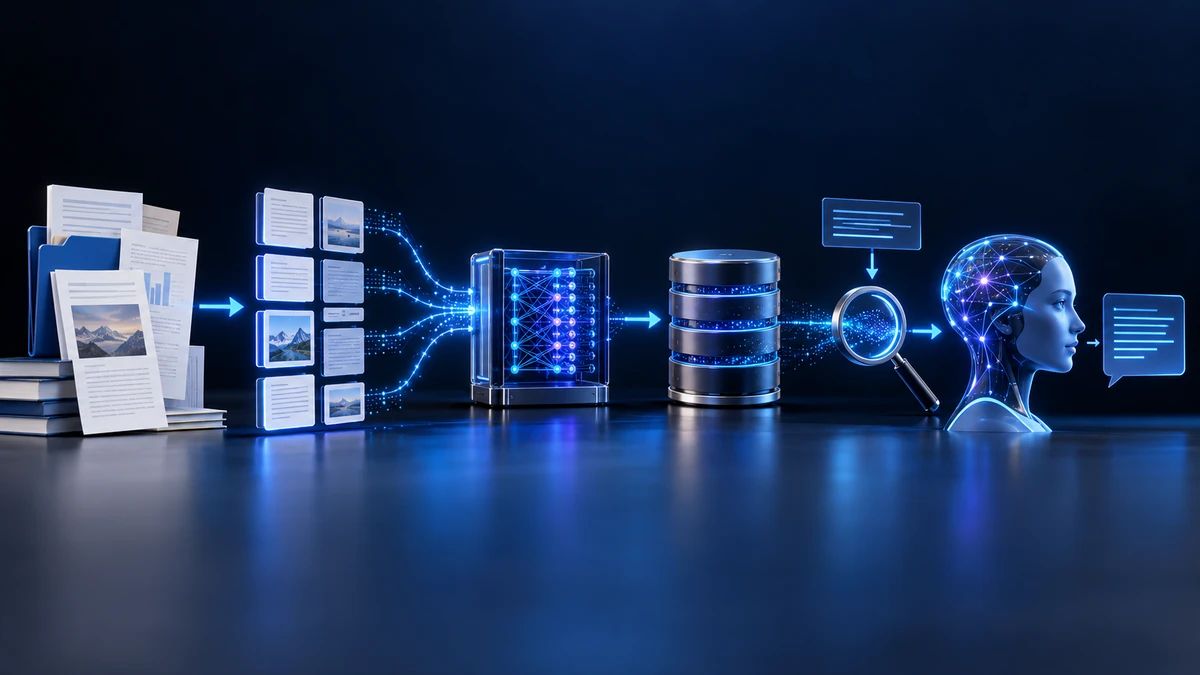
Retrieval-Augmented Generation là một trong những trường hợp sử dụng phù hợp nhất với EmbeddingGemma. Trong kiến trúc này, embedding model chịu trách nhiệm tìm kiếm ngữ cảnh liên quan, còn mô hình sinh ngôn ngữ sử dụng phần ngữ cảnh đó để tạo câu trả lời.
Bước 1: Chuẩn bị và chia nhỏ dữ liệu
Tài liệu được làm sạch và chia thành các đoạn có kích thước phù hợp. Cách chia chunk cần cân bằng giữa việc giữ đủ ngữ cảnh và tránh đưa quá nhiều nội dung không liên quan vào một vector.
Bước 2: Tạo embedding cho tài liệu
Mỗi đoạn văn bản được đưa qua EmbeddingGemma để tạo vector. Với bài toán retrieval, nên sử dụng đúng định dạng đầu vào dành cho document mà mô hình khuyến nghị để cải thiện chất lượng truy xuất.
Bước 3: Lưu vector vào cơ sở dữ liệu
Các embedding được lưu trong vector database hoặc chỉ mục tìm kiếm gần đúng. Tùy quy mô ứng dụng, nhà phát triển có thể sử dụng FAISS hay những hệ thống vector search khác có khả năng chạy trong môi trường mục tiêu.
Bước 4: Vector hóa truy vấn và tìm kiếm
Khi người dùng đặt câu hỏi, truy vấn được chuyển thành embedding tương ứng. Hệ thống sau đó so sánh vector truy vấn với các vector tài liệu để xác định những đoạn có mức tương đồng ngữ nghĩa cao nhất.
Bước 5: Đưa ngữ cảnh vào mô hình sinh
Các đoạn được truy xuất sẽ trở thành ngữ cảnh cho một mô hình ngôn ngữ phù hợp, chẳng hạn một thành viên thuộc dòng Gemma. Mô hình sinh dựa trên câu hỏi và ngữ cảnh được cung cấp để tạo câu trả lời cuối cùng.
EmbeddingGemma phù hợp với những ứng dụng nào?
- Tìm kiếm tài liệu cá nhân: lập chỉ mục ghi chú, tài liệu hoặc dữ liệu văn bản và tìm kiếm theo ý nghĩa thay vì chỉ dựa vào từ khóa.
- RAG ngoại tuyến: xây dựng trợ lý hỏi đáp trên kho dữ liệu cục bộ trong những môi trường hạn chế kết nối Internet.
- Tìm kiếm đa ngôn ngữ: hỗ trợ kho tài liệu và truy vấn thuộc nhiều ngôn ngữ trong cùng hệ thống.
- Phân loại và phân cụm: nhóm những nội dung có ý nghĩa tương tự dựa trên khoảng cách giữa các embedding.
- Tìm kiếm mã nguồn: truy xuất đoạn code liên quan từ mô tả bằng ngôn ngữ tự nhiên.
EmbeddingGemma có phải mô hình đa phương thức không?
Không. Đây là điểm cần phân biệt để tránh nhầm lẫn khi lựa chọn công nghệ. EmbeddingGemma được Google mô tả là multilingual text embedding model: đầu vào chính là văn bản và đầu ra là vector biểu diễn văn bản.
Khả năng xử lý code không đồng nghĩa với mô hình đa phương thức theo nghĩa có thể trực tiếp nhận ảnh, âm thanh hay video. Nếu một hệ thống cần tìm kiếm chéo giữa văn bản và hình ảnh hoặc giữa nhiều loại dữ liệu khác nhau, nhà phát triển cần lựa chọn mô hình multimodal embedding phù hợp hoặc xây dựng thêm tầng xử lý riêng.
EmbeddingGemma khác gì mô hình ngôn ngữ Gemma?
EmbeddingGemma và các mô hình Gemma phục vụ hai vai trò khác nhau. EmbeddingGemma biến nội dung thành vector để phục vụ truy xuất, so sánh và phân loại; mô hình ngôn ngữ Gemma nhận prompt để hiểu và sinh nội dung. Trong một hệ thống RAG, hai nhóm mô hình có thể bổ trợ cho nhau thay vì thay thế nhau.
Hiểu đơn giản: EmbeddingGemma giúp hệ thống xác định “thông tin nào liên quan”, còn mô hình ngôn ngữ đảm nhiệm việc “dùng thông tin đó để tạo câu trả lời”.
Hạn chế cần lưu ý trước khi triển khai
Kích thước nhỏ không có nghĩa EmbeddingGemma là lựa chọn tối ưu cho mọi hệ thống. Các dịch vụ embedding chạy trên máy chủ với mô hình lớn hơn có thể phù hợp hơn khi chất lượng truy xuất tối đa quan trọng hơn chi phí phần cứng, độ trễ mạng hoặc quyền riêng tư.
Hiệu quả của RAG cũng không chỉ phụ thuộc vào embedding model. Chất lượng dữ liệu, chiến lược chia chunk, cách xây dựng truy vấn, lựa chọn metric, thuật toán tìm kiếm, reranking và mô hình sinh đều có thể tác động mạnh đến kết quả cuối cùng.
Ngoài ra, con số bộ nhớ hoặc tốc độ benchmark không nên được xem là cam kết hiệu năng cho mọi thiết bị. Kết quả thực tế còn phụ thuộc phần cứng, framework suy luận, kiểu lượng tử hóa, độ dài đầu vào và cách tích hợp ứng dụng.
Đánh giá EmbeddingGemma: Nhỏ nhưng đúng với xu hướng AI cục bộ
Giá trị đáng chú ý của EmbeddingGemma nằm ở sự cân bằng giữa kích thước, chất lượng embedding và khả năng triển khai trên thiết bị. Mô hình hỗ trợ hơn 100 ngôn ngữ, MRL với nhiều kích thước vector và các tác vụ từ semantic search đến code retrieval, qua đó tạo nền tảng linh hoạt cho nhiều ứng dụng tìm kiếm thông minh.
Với các dự án cần semantic search, RAG ngoại tuyến hoặc xử lý dữ liệu nhạy cảm ngay trên thiết bị, EmbeddingGemma là một lựa chọn đáng cân nhắc. Tuy nhiên, nhà phát triển nên benchmark trên chính tập dữ liệu và phần cứng mục tiêu trước khi quyết định triển khai, bởi chất lượng của một hệ thống truy xuất luôn phụ thuộc vào toàn bộ pipeline chứ không chỉ một mô hình.