Bản chất của công nghệ Gemma 4 QAT
Gemma 4 QAT (Quantization-Aware Training) không chỉ đơn thuần là việc nén dữ liệu sau khi huấn luyện. Đây là phương pháp đưa quá trình định lượng (quantization) vào ngay giai đoạn đào tạo mô hình. Thay vì để mô hình được “học” ở độ chính xác cao rồi mới nén lại (dễ gây mất mát thông tin), QAT buộc mô hình phải thích nghi với việc biểu diễn ở độ chính xác thấp ngay từ đầu.
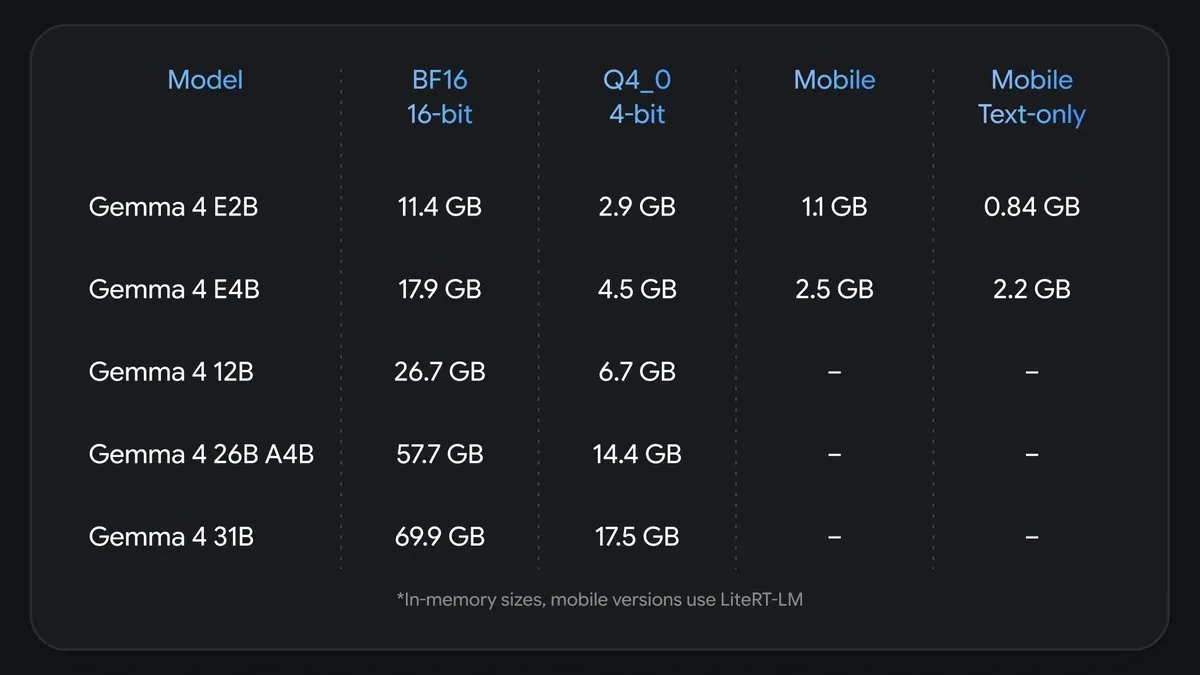
Kết quả là các phiên bản Gemma 4 tối ưu hóa có thể duy trì được độ thông minh gần như tương đương với mô hình gốc, trong khi dung lượng bộ nhớ (VRAM) được cắt giảm đáng kể, giúp thiết bị phổ thông cũng có thể vận hành trơn tru.
Tại sao QAT vượt trội hơn phương pháp Post-Training Quantization (PTQ)?
Để hiểu rõ sự khác biệt, chúng ta cần so sánh giữa cách tiếp cận truyền thống và phương pháp QAT tiên tiến:
| Tiêu chí | Post-Training Quantization (PTQ) | Quantization-Aware Training (QAT) |
|---|---|---|
| Thời điểm định lượng | Sau khi mô hình đã huấn luyện xong | Ngay trong quá trình huấn luyện |
| Độ chính xác | Có thể bị suy giảm do mất thông tin | Bảo toàn tối đa nhờ khả năng thích nghi |
| Độ phức tạp | Thấp, triển khai nhanh | Cao, tốn tài nguyên tính toán hơn |
| Hiệu suất thiết bị | Tốt | Tối ưu vượt trội (đặc biệt trên chip di động) |
Các chiến lược tối ưu hóa Gemma 4 dành cho thiết bị biên (Edge)
Nhóm phát triển đã áp dụng nhiều kỹ thuật chuyên sâu để đưa Gemma 4 lên các thiết bị như điện thoại hay laptop cá nhân:
- Định lượng kênh (Channel-wise quantization): Dữ liệu được cấu trúc lại để khớp với kiến trúc phần cứng của các bộ tăng tốc trên di động, cho phép tính toán trực tiếp mà không cần trung gian.
- Định lượng 2-bit mục tiêu: Các lớp sinh token được nén cực mạnh về 2-bit, trong khi các lớp suy luận cốt lõi vẫn giữ độ chính xác cao để đảm bảo tư duy logic cho AI.
- Kích hoạt tĩnh (Static activations): Loại bỏ việc tính toán tỷ lệ dữ liệu theo thời gian thực, giúp giảm tải đáng kể cho chip xử lý và tăng tốc độ phản hồi.
- Tối ưu hóa KV Cache: Tập trung nén danh sách từ vựng và bộ nhớ ngắn hạn, cho phép người dùng thực hiện các phiên hội thoại dài mà không lo tràn bộ nhớ.
Checklist ứng dụng Gemma 4 QAT hiệu quả
Nếu bạn là nhà phát triển hoặc người dùng muốn tối ưu hóa mô hình AI tại nhà trong năm 2026, hãy thực hiện theo quy trình sau:
- Xác định nhu cầu: Chọn phiên bản Gemma 4 phù hợp với phần cứng (E2B cho thiết bị siêu nhẹ, E4B cho hiệu năng cân bằng).
- Tải trọng số: Truy cập Hugging Face để lấy tệp checkpoint QAT (hỗ trợ định dạng GGUF cho llama.cpp hoặc các tệp đã nén cho vLLM).
- Lựa chọn runtime: Tùy vào môi trường, sử dụng các công cụ hỗ trợ như Ollama, LM Studio cho desktop hoặc LiteRT-LM cho thiết bị di động.
- Tinh chỉnh modal: Nếu chỉ sử dụng tính năng chatbot văn bản, hãy loại bỏ các trình mã hóa âm thanh/hình ảnh không cần thiết để giảm thiểu footprint bộ nhớ xuống dưới 1GB.
Góc nhìn chuyên gia: Tương lai của AI trên thiết bị
Việc áp dụng QAT vào dòng mô hình Gemma 4 đánh dấu sự chuyển dịch quan trọng từ điện toán đám mây sang điện toán biên (Edge AI). Trong năm 2026, rào cản về phần cứng không còn là yếu tố ngăn cản trải nghiệm AI mạnh mẽ. Khả năng chạy các mô hình lớn với dung lượng dưới 1GB mà vẫn giữ nguyên chất lượng là minh chứng cho việc tối ưu hóa phần mềm có thể “kéo” sức mạnh phần cứng đi xa như thế nào. Đối với người dùng cá nhân, đây là cơ hội để sở hữu những trợ lý thông minh riêng tư, chạy hoàn toàn offline với tốc độ cực nhanh.